


Petit détaillant


Comprendre le comportement
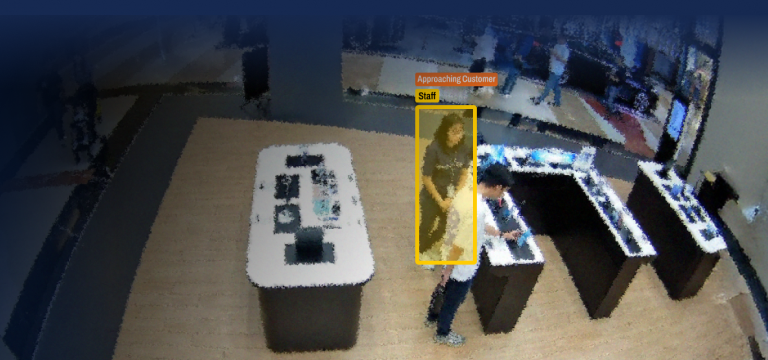
VLM étend l'analyse au-delà de la position et de la durée, en interprétant ce que font les gens dans un contexte de vente au détail défini.
Les analyses traditionnelles permettent d'identifier la présence, le temps passé, les trajets et la proximité. La VLM y ajoute une compréhension comportementale. Elle interprète des actions telles que la navigation, la manipulation de produits, les interactions avec le personnel, la réalisation d'un service ou une présence non pertinente, ce qui permet aux mêmes données de déplacement de devenir plus significatives et plus mesurables.
Comptes dans le contexte
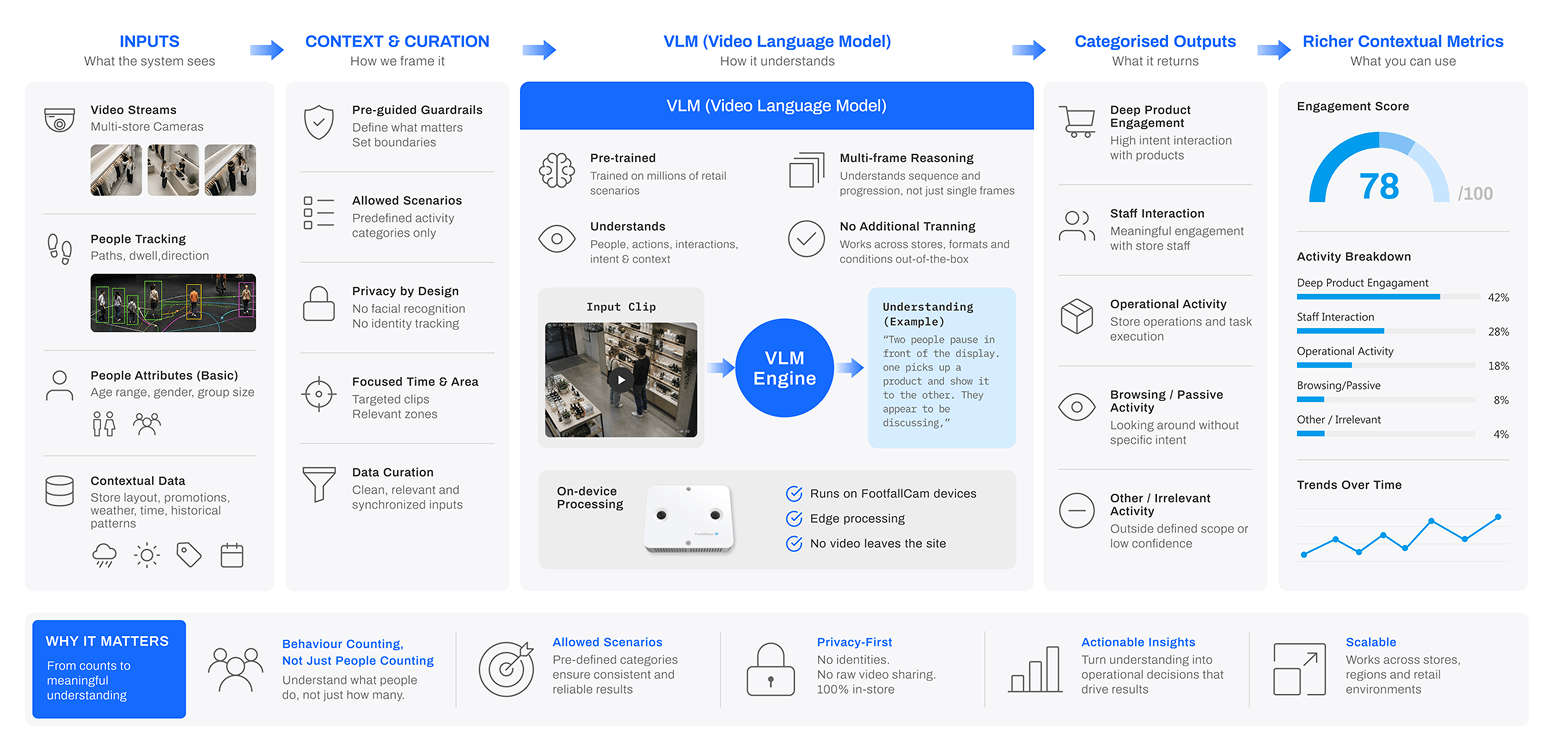
FootfallCam VLM combine le suivi des personnes, l'activité par zone, les attributs démographiques, le comportement des groupes, l'agencement du magasin et des données contextuelles telles que les promotions ou les conditions d'exploitation. VLM utilise ce contexte structuré pour classer les événements en catégories définies, créant ainsi des indicateurs plus précis sur l'engagement produit, l'interaction avec le service et l'activité opérationnelle.
Fonctionnement
Les moments pertinents sont sélectionnés, interprétés, classés et convertis en indicateurs de performance commerciale structurés. L'analyse vidéo du cycle de vie (VLM) est appliquée dans des contextes commerciaux définis. Le système se concentre sur les zones, les périodes et les types d'événements pertinents, puis interprète le moment vidéo sélectionné à l'aide de questions et de règles de classification prédéfinies. Le résultat n'est pas une description libre, mais un résultat structuré et associé à des catégories commerciales prédéfinies.
Étape 1
Détecter l'instant
Le suivi permet d'identifier un événement pertinent, tel que la durée de présence en rayon, la proximité du personnel ou l'activité de service.
Étape 2
Ajouter un contexte
L’agencement du magasin, le type de zone, le comportement des groupes, l’heure, les promotions et l’historique des déplacements constituent le contexte opérationnel.
Étape 3
Interpréter le comportement
VLM analyse la séquence vidéo et détermine le comportement observé.
Étape 4
Classer le résultat
Le résultat est converti en catégories structurées telles que l'engagement produit, l'interaction avec le personnel, la tâche opérationnelle ou l'activité non pertinente.
Pourquoi VLM fonctionne
VLM est pré-entraîné à comprendre un large éventail de situations visuelles. Cela permet FootfallCam L'objectif est d'appliquer la compréhension vidéo à différents comportements de vente au détail sans avoir à entraîner un modèle distinct pour chaque scénario. Le système peut interpréter le contexte multi-images, comprendre les schémas d'interaction et fournir des résultats ciblés en fonction de questions prédéfinies.
Métriques contextuelles
Le VLM transforme les comportements observés en catégories mesurables reflétant l'activité réelle en magasin. Le temps passé par une personne devant un rayon n'est plus le seul indicateur mesuré. Le VLM permet de déterminer si elle jette un coup d'œil, regarde, évalue activement un produit, interagit avec le personnel ou reste inactive. Ces classifications deviennent des indicateurs structurés, consultables, agrégés et comparables d'un magasin à l'autre.

Engagement produit
Permet de classifier l'attention des clients, depuis un intérêt passager jusqu'à une évaluation active du produit, aidant ainsi les détaillants à comprendre quels présentoirs suscitent un engagement significatif.

Interaction avec le personnel
Identifie les moments clés du service, tels que l'accueil, l'assistance, la consultation, la vente additionnelle ou la prise en charge, permettant ainsi une mesure plus cohérente de la qualité du service.

Activité opérationnelle
Permet de reconnaître les activités définies du personnel telles que le réapprovisionnement, le déplacement de cartons, le nettoyage ou l'achèvement des tâches, aidant ainsi les équipes à mesurer le respect des procédures opérationnelles.
Même instant, signification différente
Un même emplacement et une même durée de présence peuvent correspondre à des comportements très différents. La VLM permet de les distinguer. Un client peut rester au même endroit pendant la même durée, mais son comportement peut être totalement différent. Il peut être distrait par son téléphone, jeter un coup d'œil rapide, naviguer activement, manipuler un produit, discuter de manière informelle ou parler du produit avec une autre personne. La VLM permet de différencier ces situations.
Distraction liée au téléphone
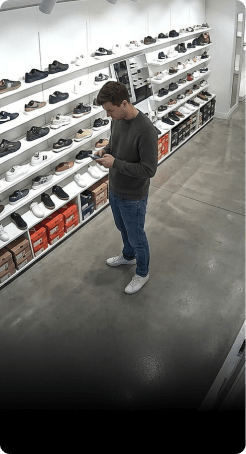
Sortie VLMPersonne immobile, son attention portée sur son appareil mobile. Aucune interaction avec le produit.
Pas engagé
Coup d'œil rapide
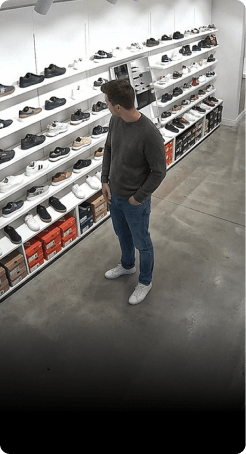
Sortie VLMBrève attention visuelle portée aux produits, sans interaction manuelle
Niveau 1 : Engagement léger
Navigation active
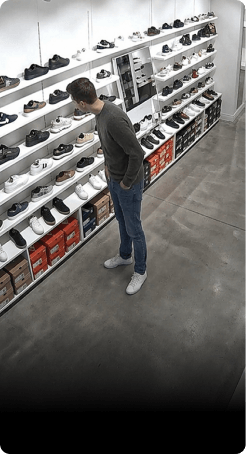
Sortie VLM: Concentration visuelle soutenue sur les produits présentant un comportement exploratoire.
Niveau 2 : Navigation
Interaction profonde avec le produit
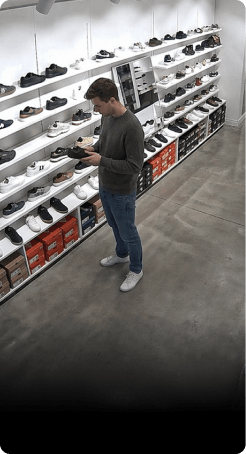
Sortie VLM: Comportement direct de manipulation et d'évaluation du produit.
Niveau 3 : Engagement élevé
Parler à un ami
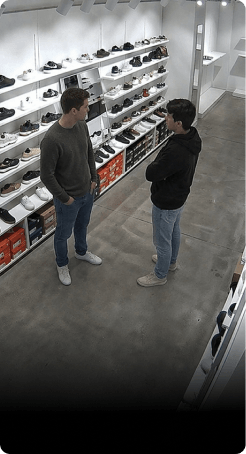
Sortie VLMConversation détectée, non liée à l'interaction avec le produit
Pas engagé
Parlons du produit
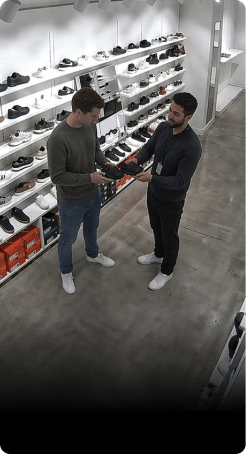
Sortie VLM: Attention partagée portée au produit, accompagnée de discussions.
Niveau 4 : Engagement du personnel
Illustrations générées par IA uniquement ; aucune donnée client réelle, aucune image de surveillance ni aucune information personnelle n'est utilisée ni capturée.
Résultats vérifiables
Chaque événement classifié peut être examiné, expliqué et aligné sur la définition opérationnelle du détaillant. VLM ne se contente pas d'apposer une étiquette. Il fournit une explication concise de l'observation, comme la manipulation de produits, l'attention partagée, l'assistance du personnel ou une présence inappropriée. Les équipes peuvent ainsi analyser les événements sélectionnés, valider les résultats et affiner les définitions au fil du temps.
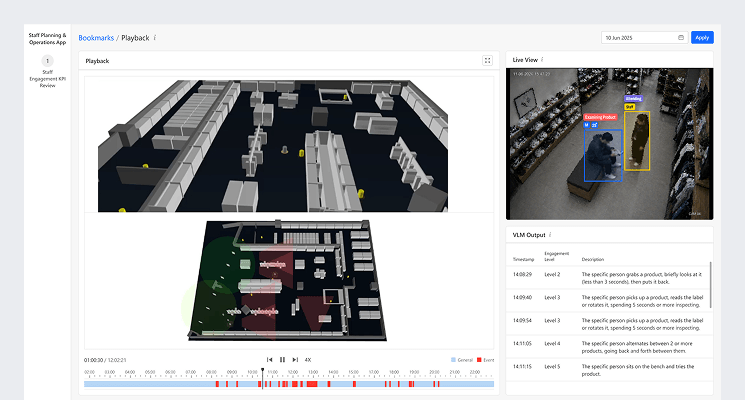
Examen de la preuve
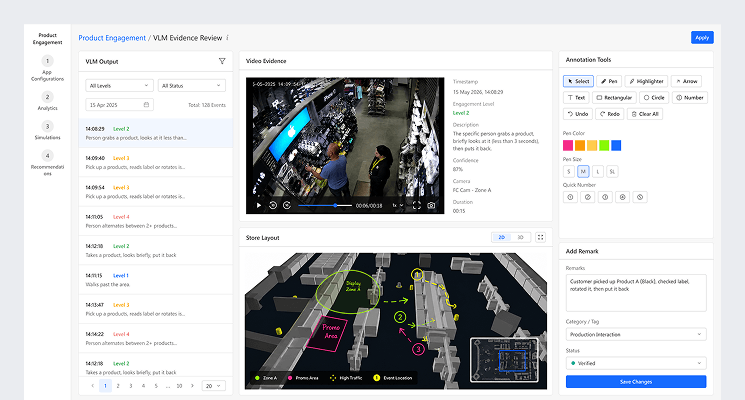
Chaque événement classifié peut être examiné à l'aide de preuves vidéo, de détails contextuels et des commentaires d'un examinateur avant d'être intégré au rapport. L'espace de travail d'examen transforme les données VLM en un processus opérationnel. Les examinateurs peuvent analyser l'enregistrement de l'événement, comprendre la raison de la classification de l'interaction, la comparer au contexte géographique, ajouter des annotations et confirmer le résultat final. Ceci garantit que les indicateurs contextuels restent mesurables, explicables et alignés sur l'activité réelle du magasin.
Compte rendu détaillé de l'événement
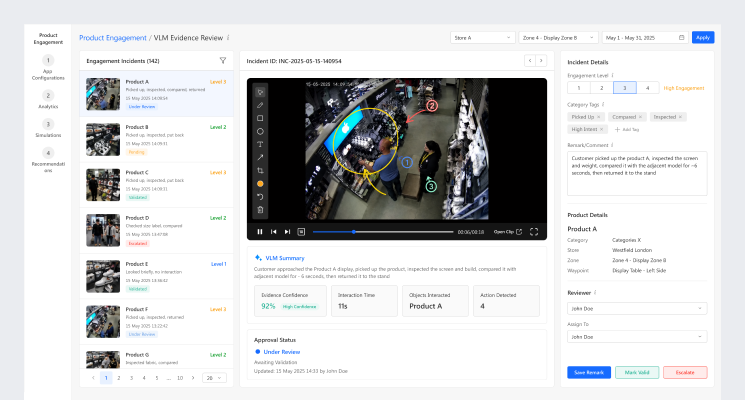
Flux de travail de validation des incidents
Compte rendu détaillé de l'événement
Compte rendu détaillé de l'événement
Cet espace de travail est conçu pour l'analyse détaillée d'un événement VLM. L'analyste peut examiner l'enregistrement vidéo, vérifier l'horodatage, le niveau d'engagement, la description, le niveau de confiance et la source de la caméra, puis comparer l'événement au plan du magasin. Des outils d'annotation permettent de marquer directement sur l'enregistrement les mouvements, produits ou points d'interaction importants. L'analyste peut ajouter des remarques, attribuer une catégorie et confirmer le statut final avant d'enregistrer le résultat.
Flux de travail de validation des incidents
Flux de travail de validation des incidents
Cette vue est conçue pour l'analyse opérationnelle à grande échelle. Les incidents d'engagement sont présentés dans une file d'attente structurée, permettant aux équipes de passer rapidement d'un événement à l'autre tout en conservant une visibilité complète des preuves. L'espace de travail combine le clip de l'événement, le résumé VLM, le niveau de confiance des preuves, le niveau d'engagement, les détails du produit, l'attribution du réviseur et les contrôles d'approbation. Cela permet à l'organisation de valider, d'escalader ou d'approuver les incidents selon un flux de travail rigoureux avant que les résultats ne soient utilisés dans les tableaux de bord ou l'analyse des performances.
Contrôlé par la conception
Le système fonctionne selon des zones, des déclencheurs, des questions et des catégories prédéfinis. Il se concentre sur les comportements que le détaillant a choisi de mesurer, tels que l'engagement, l'interaction avec le service client ou le respect des procédures opérationnelles. Les résultats sont structurés en catégories et en indicateurs, et non en descriptions vidéo libres.
Portée définie
L'analyse se limite à certaines zones, types d'événements et conditions de fonctionnement.
Questions définies
Le système répond à des questions métier prédéfinies, comme par exemple si une interaction avec le produit ou le personnel a eu lieu.
Sorties définies
Les résultats sont renvoyés sous forme de catégories structurées, de scores et de métriques à des fins de reporting et de validation.
Compréhension de pointe
L'interprétation VLM peut s'exécuter en périphérie, au plus près de la caméra et de l'environnement de stockage. Cela permet de classifier localement les événements pertinents avant l'envoi des résultats structurés à la plateforme. L'accent est mis sur les indicateurs, les catégories et les résultats de validation plutôt que sur le transfert de données vidéo superflues.
Applications de vente au détail
VLM prend en charge des cas d'usage concrets dans le commerce de détail où les données de mouvement seules ne fournissent pas suffisamment d'informations. Dans tous les environnements de magasin, VLM aide à identifier les moments clés du parcours client et du fonctionnement du magasin. Ces données peuvent faciliter le merchandising, l'amélioration de la qualité de service, l'analyse des passages en caisse, la formation du personnel et la conformité opérationnelle.
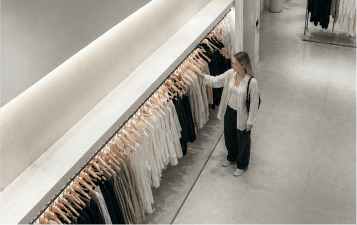
Engagement en rayon
Mesurer la manière dont les clients interagissent avec les produits, depuis une brève attention et une navigation jusqu'à une évaluation active et une manipulation du produit.
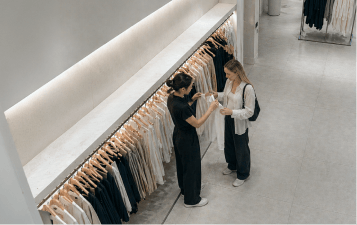
Interaction avec le personnel
Identifier les moments clés du service, tels que l'accueil, l'assistance, la consultation et les interactions clients finalisées.
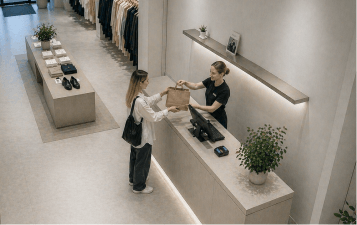
Finalisation du paiement
Suivre les étapes clés du service, de l'arrivée dans la file d'attente jusqu'à la transaction, la prise en charge et la fin du service.
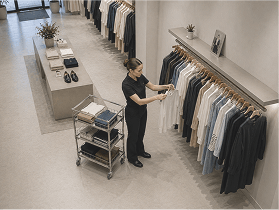
Adhésion opérationnelle
Mesurer les activités opérationnelles telles que le réapprovisionnement, le nettoyage, la manutention des marchandises et l'exécution des tâches.
Parcours de conversion
Reliez l'engagement, l'interaction avec le service et l'activité de paiement pour comprendre où les opportunités de conversion apparaissent ou diminuent.